声音拓展:波形怎样变成“救命”这个词
复用训练、评估和部署流程,重点补声音输入与特征变换。先看时域与频域,再逐步解释项目为何准备 40×32 个特征。
1 · 声音和动作数据有什么相同与不同
麦克风采样也是随时间变化的一串数,仍需连续记录、标签、窗口与独立测试。但声音的细节常体现在不同频率成分如何随时间变化。不同距离、说话人、背景声和麦克风采样率都会改变输入。
先画一小段原始声音,标出直流偏置与幅度,再去偏置。采样率决定同一批点对应多长时间;传感器章节的实际 ADC 配置与 kws_mfcc.h 中的 KWS_SAMPLE_RATE 必须核对,不能凭一个旧注释中的频率完成部署。
2 · 为什么要看频率
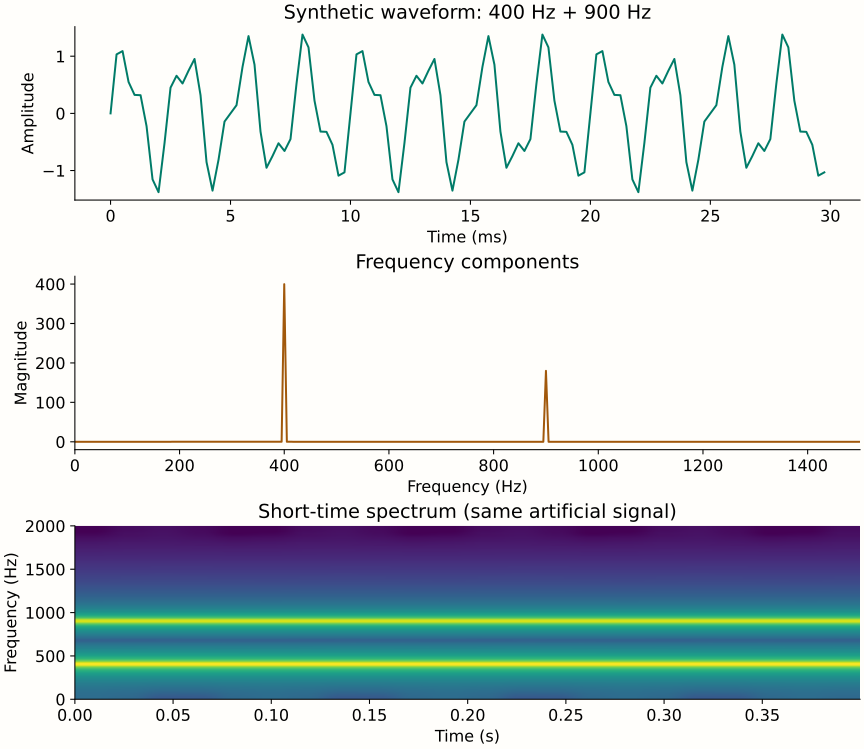
把声音分成短片段,每段乘窗函数减少截断带来的边缘影响,再通过快速傅里叶变换观察频率成分。先用单频正弦、两个正弦相加做图,看到频谱峰值怎样对应输入,然后再讨论真实语音。
多个短片段的频谱按时间排开形成时频图。时间分辨率与频率分辨率需要取舍,不是把窗口加大就所有细节都更清楚。频域基础放在本节配图说明,不直接贴整份频谱代码。
3 · 梅尔频率倒谱系数从哪里来
项目使用梅尔滤波器组聚合频带能量,再取对数、做离散余弦变换得到系数。这组语音特征简称 MFCC,即梅尔频率倒谱系数。每一步先展示输入与输出图,再引入缩写。
当前模型使用 40 个系数与 32 个时间帧,共 1280 个数。训练和主控必须一致采用窗长、步长、滤波器范围、归一化和排列顺序。MFCC 名称相同并不保证不同库的默认参数相同。
4 · 沿当前关键词任务读数据
TaskKWS 从自己的麦克风通道取得帧,累积较长声音窗口,计算特征,再按模型比例和零点量化。当前代码将系数优先排列为 coeff*32+frame;读 kws_model.h 的旧参数注释时应以实际任务写入和生成网络元数据为准。
包装参数名使用 int8_t,但网络元数据描述 uint8 量化;必须区分原始字节位模式与数学上的有符号数值。用一组固定音频比较 Python 与 C 每个特征及最终输入字节,再看识别是否一致。
5 · 评估先覆盖真实声音环境
训练与测试按说话人或独立录音场次分开,加入静音、普通聊天和背景声。分别记录漏识别和误触发,以及连续多帧确认带来的延迟。当前类序为救命、帮帮我、silence、unknown,换模型时不能沿用错误的输出位置。
用两段同一词的不同录音,比较波形和时频图;再记录当前 ADC 采样率、声音窗口时长与训练参数的对应。没有原训练参数时,把不确定项写明,不将现场误差都归咎于模型。