训练在改变什么:从一个分数手算起
先用两个特征计算判断分数,再看预测错误如何推动参数变化。损失、梯度和学习率都通过可计算的小例子引入。
1 · 先写出一个能手算的判断
对一段动作,先提取“波动程度”和“变化速度”两个数,记作 x1、x2。一个简单判断分数可以写为 w1*x1 + w2*x2 + b。x 是样本,w 是每个特征的权重,b 是偏置;同一输入在参数确定后总会按同一公式计算。
输出 0.2;自己调整权重观察分界变化
x1, x2 = 2.0, 1.0
w1, w2, b = 0.3, 0.1, -0.5
score = w1*x1 + w2*x2 + b
print(score)
几个类别可以各有一个分数,先取最大者作为预测。分数本身不必是概率。softmax 可把一组分数变成总和为一的数值,但它仍需要用真实评估检查置信度是否可靠。
2 · 错误怎样变成一个数
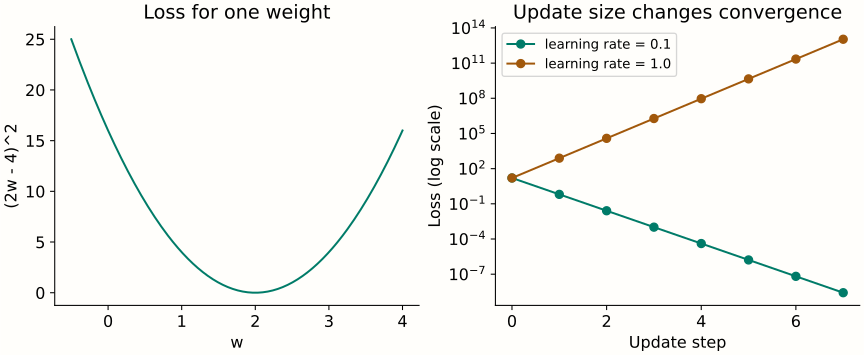
先练习拟合一个目标数,用 (预测-目标)² 表示错误,叫平方损失。预测接近目标时变小,偏离时变大。分类有专门适合类别答案的交叉熵损失,后面的框架训练会使用它。损失选什么,要与输出和标签含义对应。
把损失对一个权重画成曲线:斜坡方向说明增大权重会让错误变大还是变小。导数描述这一变化率,多项参数对应的一组变化率叫梯度。先理解沿下降方向调整,不必先推导整张深层网络。
3 · 用一行明确更新参数
普通 Python · 手算梯度与更新方向
x, target = 2.0, 4.0
w = 0.0
for step in range(5):
    error = w*x - target
    gradient = 2*error*x
    w = w - 0.1*gradient
    print(w, error*error)
这里的 0.1 是学习率,决定每次沿梯度反方向走多远。太大可能来回越过低点,太小收敛很慢。打印的损失是本次更新前的错误,想观察更新后结果要重新计算,不能混淆步骤顺序。
4 · 一个神经元怎样变成多层网络
加权求和以后可以接一个非线性函数,例如 ReLU 把负数变成零、正数保留。多个这样的计算组合成一层,再逐层处理输入。没有非线性,多次线性变换仍能合成一次线性变换,表达能力没有因“层数多”自动增加。
网络前向计算得到预测,反向传播把损失对参数的梯度从后向前计算出来。自动求导负责做这项数值工作,优化器负责使用梯度更新参数。它们并没有自动决定标签是否正确,也不会修复错误单位。
5 · 下一篇怎样使用框架而不把步骤藏掉
先用已经准备好的 [批,6,512] 张量,展平后接一个小全连接网络。先看清输入和输出形状,再逐行执行前向、损失、清梯度、反向和更新。教学模型参数规模很小,CPU 即可跑通。
把手算更新的学习率改成 1.0,观察错误是否变大;再改成 0.01。给两个简单类别画二维点和一条分界线,解释哪些点会被分错。